Votre site reçoit chaque jour la visite de robots : celui de Google, ceux d’autres moteurs, et de plus en plus ceux des services d’intelligence artificielle. Un petit fichier texte, le robots.txt, vous permet de leur dire où ils peuvent aller. Encore faut-il savoir ce qu’il fait vraiment, et surtout ce qu’il ne fait pas. Voyons ensemble comment il fonctionne, que bloquer, que laisser passer, et comment gérer les robots des IA sans vous priver de visibilité.
Le robots.txt, à quoi ça sert ?
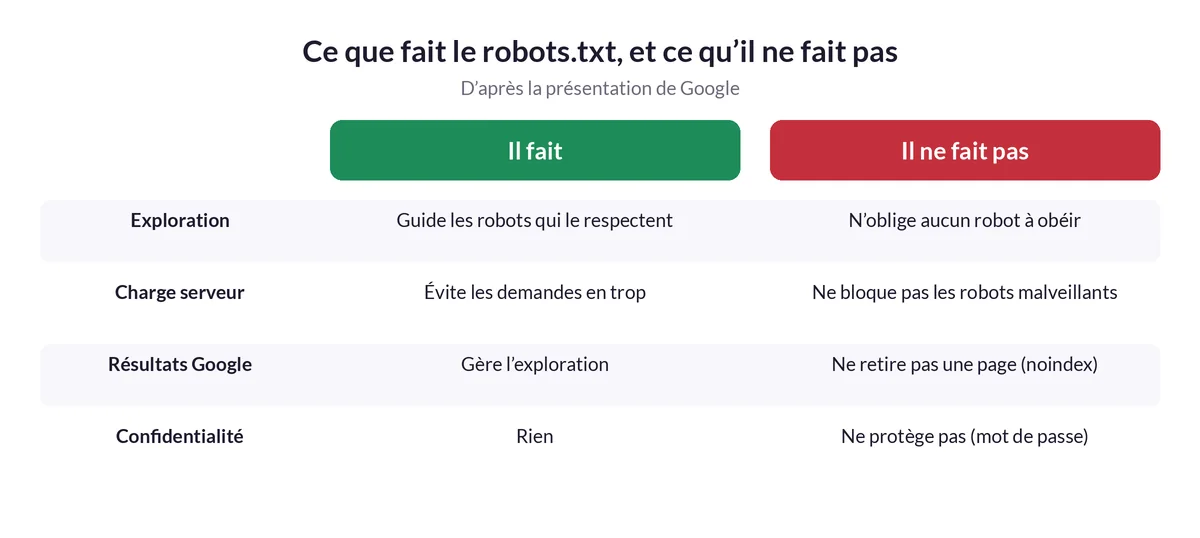
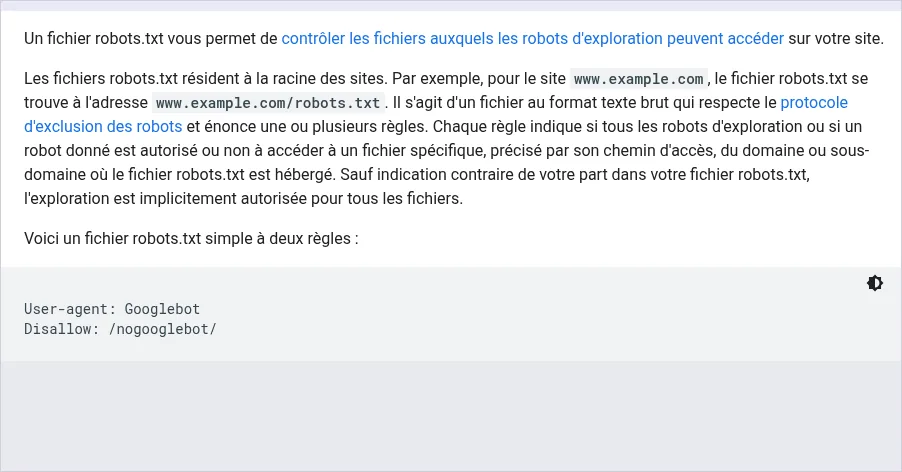
La présentation du fichier robots.txt par Google le résume ainsi : ce fichier indique aux robots d’exploration d’un moteur de recherche les URL auxquelles ils peuvent accéder sur votre site. Son objectif principal est d’éviter de surcharger votre site de demandes.
Point essentiel, souvent mal compris : selon Google, il ne sert pas à empêcher qu’une page figure dans les résultats de recherche. Pour cela, il faut bloquer l’indexation avec une balise noindex ou protéger la page par un mot de passe.
Ses limites : un panneau, pas une porte fermée
Google est très clair sur un autre point : les instructions d’un robots.txt ne peuvent pas obliger un robot à les respecter. Googlebot et les autres robots sérieux s’y conforment, mais d’autres peuvent les ignorer. Pour protéger des informations confidentielles, Google recommande donc d’autres méthodes, comme la protection par mot de passe.
Retenez donc la règle : le robots.txt organise l’exploration, il ne cache rien et ne sécurise rien. Une page privée doit être protégée autrement.
Comment il est construit
Le guide de Google pour créer un fichier robots.txt donne les règles de base :
- le fichier se trouve à la racine du site, par exemple
www.example.com/robots.txt, jamais dans un sous-dossier ; - c’est un fichier au format texte brut ;
- il se compose de groupes, et chaque groupe commence par une ligne
User-agentqui désigne le robot concerné ; - par défaut, un robot peut explorer tout ce qui n’est pas bloqué par une règle
Disallow; - les règles sont sensibles à la casse :
/file.aspne bloque pas/FILE.asp; - une ligne
Sitemappeut indiquer l’adresse de votre plan de site.
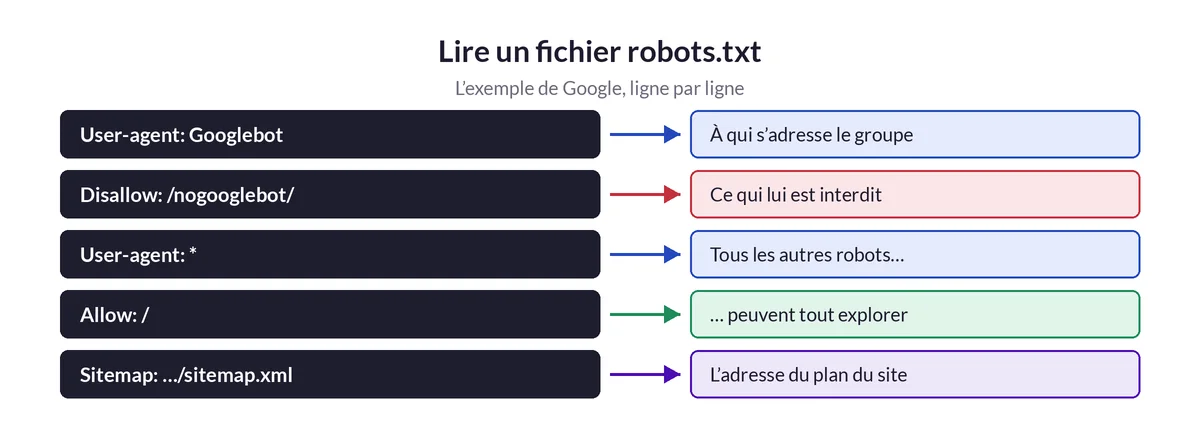
L’exemple de Google interdit au robot nommé Googlebot les adresses qui commencent par /nogooglebot/, laisse tous les autres robots explorer l’ensemble du site, et signale le plan du site. Simple et lisible.
Les pièges à éviter
La présentation de Google signale plusieurs subtilités qui méritent votre attention :
- Tous les moteurs ne lisent pas les règles de la même façon. Google précise que les règles du robots.txt ne sont pas forcément compatibles avec tous les moteurs de recherche, et que les robots peuvent interpréter la syntaxe de différentes façons. Restez sur des règles simples.
- Les images, vidéos et fichiers audio : bloquer leur exploration les empêche d’apparaître dans les résultats de Google, mais n’empêche pas d’autres pages ou utilisateurs de créer des liens vers eux.
- Les scripts et feuilles de style : vous pouvez bloquer des ressources sans importance, mais Google prévient que si leur absence rend la page plus difficile à comprendre pour son robot, mieux vaut ne pas les bloquer.
En clair, un robots.txt court et lisible vaut mieux qu’une longue liste d’exceptions que personne ne relira.
Les robots des IA : ce que vous pouvez choisir
Les éditeurs d’IA ont créé des noms de robots spécifiques pour que vous puissiez choisir. Deux exemples officiels :
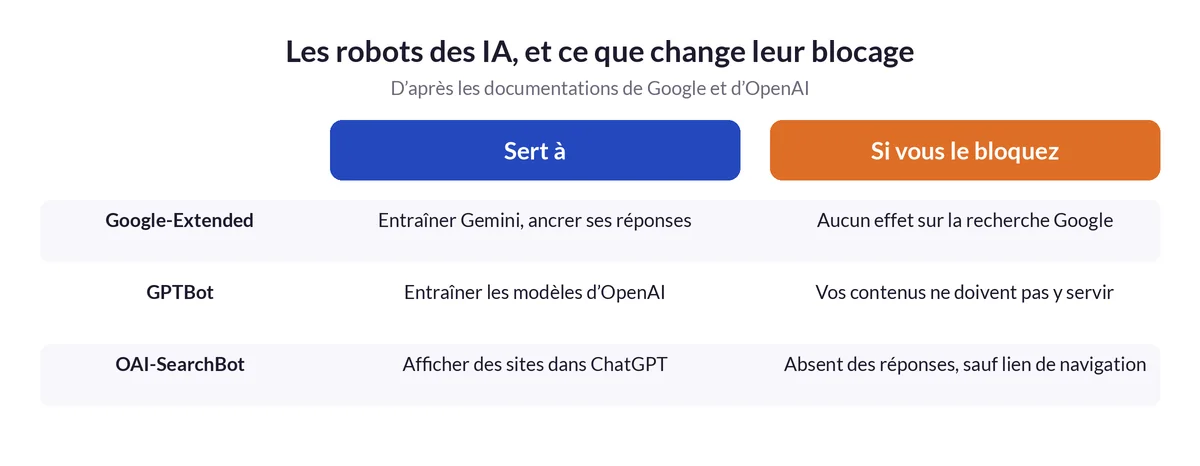
Chez Google, Google-Extended. La liste des robots d’exploration de Google le présente comme un jeton que les éditeurs web peuvent utiliser pour choisir si le contenu exploré sur leurs sites peut servir à entraîner les futures générations de modèles Gemini et à l’ancrage de leurs réponses. Google précise que Google-Extended n’a aucune incidence sur l’inclusion d’un site dans la recherche Google et n’est pas utilisé comme signal de classement. Le bloquer ne vous retire donc pas des résultats de recherche.
Chez OpenAI, deux robots distincts. La documentation d’OpenAI sur ses robots indique que chaque réglage est indépendant. GPTBot explore des contenus pouvant servir à l’entraînement de ses modèles : le bloquer indique que vos contenus ne doivent pas y servir. OAI-SearchBot sert à afficher des sites dans les résultats de recherche de ChatGPT : un site qui le bloque n’apparaîtra pas dans ces réponses, sauf comme simple lien de navigation.
Un troisième nom apparaît dans la documentation d’OpenAI : ChatGPT-User. Il visite une page quand un utilisateur de ChatGPT le demande, et OpenAI précise qu’il ne sert pas à explorer le web de façon automatique. Comme ces visites sont déclenchées par une personne, les règles du robots.txt peuvent ne pas s’appliquer.
Que bloquer, que laisser passer ?
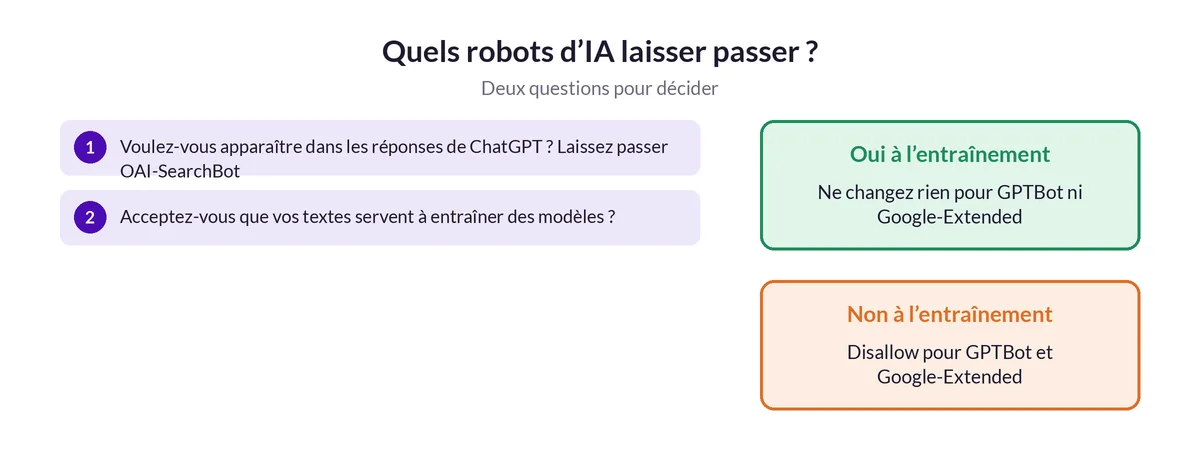
Tout dépend de votre objectif. Si vous voulez apparaître dans les réponses des moteurs et des assistants, laissez passer Googlebot et OAI-SearchBot. Si vous ne souhaitez pas que vos textes servent à entraîner des modèles, vous pouvez bloquer Google-Extended et GPTBot, sans effet sur votre présence dans la recherche Google selon la documentation de Google.
Exemple fictif : une créatrice de patrons de couture publie des tutoriels détaillés. Elle veut être trouvée sur Google et dans ChatGPT, mais pas alimenter l’entraînement des modèles. Elle ajoute donc deux groupes à son robots.txt : un User-agent : GPTBot suivi de Disallow : /, puis un User-agent : Google-Extended suivi de Disallow : /. Elle ne touche à rien pour Googlebot et OAI-SearchBot.
Gardez en tête que ce fichier exprime une préférence, adressée aux robots qui acceptent de le lire. Et un robot peu scrupuleux pourra toujours l’ignorer.
Vérifier votre fichier
Une erreur dans le robots.txt peut bloquer tout votre site par accident : un simple Disallow : / dans le groupe de tous les robots suffit. Le rapport robots.txt de la Search Console affiche les fichiers trouvés par Google pour les 20 principaux hôtes de votre site, la date de la dernière exploration, ainsi que les avertissements et erreurs. Google y précise qu’il ignore les lignes présentant des problèmes et utilise celles qu’il peut analyser. Le rapport permet aussi de demander une nouvelle exploration du fichier en cas d’urgence.
Notre guide pour apparaître dans les réponses de ChatGPT et de Google complète celui-ci côté contenu. Pour comprendre comment Googlebot explore un site servi par un CDN, lisez aussi notre article sur l’exploration et les CDN. Et la formation Référencement SEO et GEO vous guide pas à pas.
Questions fréquentes
Le robots.txt empêche-t-il une page d’apparaître sur Google ?
Non. Google rappelle que ce fichier sert à gérer l’exploration, pas l’indexation. Pour retirer une page des résultats, utilisez une balise noindex ou protégez-la par un mot de passe.
Où placer le fichier robots.txt ?
À la racine de votre site, par exemple à l’adresse votresite.fr/robots.txt. Un fichier placé dans un sous-dossier n’est pas pris en compte.
Bloquer Google-Extended fait-il baisser mon référencement ?
Non. Selon Google, Google-Extended n’a aucune incidence sur l’inclusion d’un site dans la recherche Google et n’est pas un signal de classement. Il concerne l’usage de vos contenus pour Gemini.
Quelle différence entre GPTBot et OAI-SearchBot ?
GPTBot explore des contenus pouvant servir à entraîner les modèles d’OpenAI. OAI-SearchBot sert à afficher des sites dans la recherche de ChatGPT. Les deux se règlent séparément dans votre robots.txt.
Tous les robots respectent-ils le robots.txt ?
Non. Google précise que les robots sérieux s’y conforment, mais que d’autres peuvent ignorer ses instructions. Pour des contenus confidentiels, une protection par mot de passe reste indispensable.