Votre site grandit, il ralentit aux heures de pointe, et quelqu’un vous a conseillé de passer à un CDN, un réseau de diffusion de contenu. Excellente idée ! Mais Google vient de publier, le 11 novembre 2026, un article plein d’humour qui met en garde contre deux mauvaises surprises au moment de la bascule : une avalanche de visites de ses robots sur votre serveur, et un pare-feu trop zélé qui bloque Googlebot. Résultat possible : des pages qui disparaissent des résultats de recherche. Voici comment passer à un CDN en gardant Google de votre côté.
Un CDN, à quoi ça sert ?
Un CDN copie les éléments de votre site (pages, images, feuilles de style, scripts) sur de nombreux serveurs dits « périphériques », répartis dans le monde et proches de vos visiteurs. Comme le résume l’article du blog de Google Search Central, cela réduit le temps de chargement et protège votre serveur d’origine, celui qui contient le site, des pics de trafic.
Nous évoquions déjà cette solution dans notre article quand votre site ralentit avec l’afflux de visites. Beaucoup d’hébergeurs et d’extensions de cache, comme celles présentées dans notre article sur les alternatives à WP Rocket, proposent d’ailleurs d’en activer un en quelques clics.
Première surprise : les robots de Google accélèrent
Google part d’un constat que lui remontent des propriétaires de sites : juste après le passage à un CDN, le trafic des robots d’exploration vers leur serveur augmente presque immédiatement. Exactement l’inverse de l’effet recherché !
L’explication tient à la façon dont Google règle la vitesse d’exploration de chaque site, qu’il appelle la « limite de capacité d’exploration » :
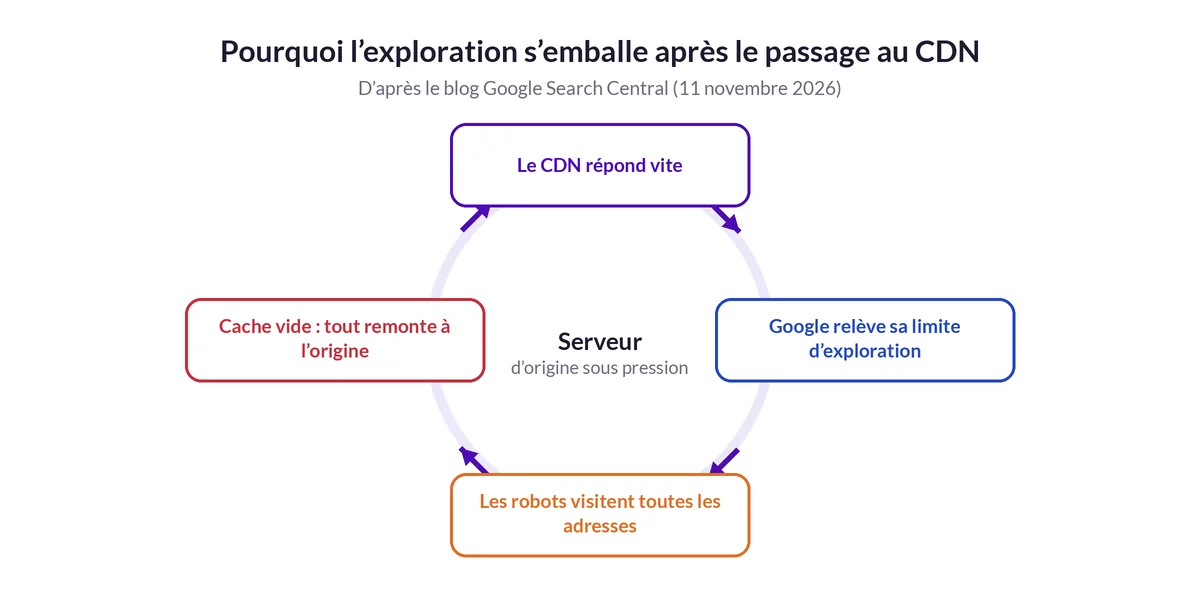
- Quand votre serveur répond lentement, les robots ralentissent pour ne pas le surcharger.
- Quand il répond vite et de façon stable, Google y voit le signe d’une infrastructure saine et augmente progressivement le rythme, si la demande d’exploration le justifie.
Or, dès que votre nom de domaine pointe vers le CDN, les temps de réponse chutent. Pour Google, écrit-il, cela ressemble à « une mise à niveau matérielle massive » de votre serveur. Ses robots augmentent donc leur fréquence de visite.
Le vrai piège : le cache vide
En soi, plus d’exploration n’est pas un problème, si le CDN absorbe les requêtes. Sauf qu’un CDN tout neuf démarre avec un cache vide.
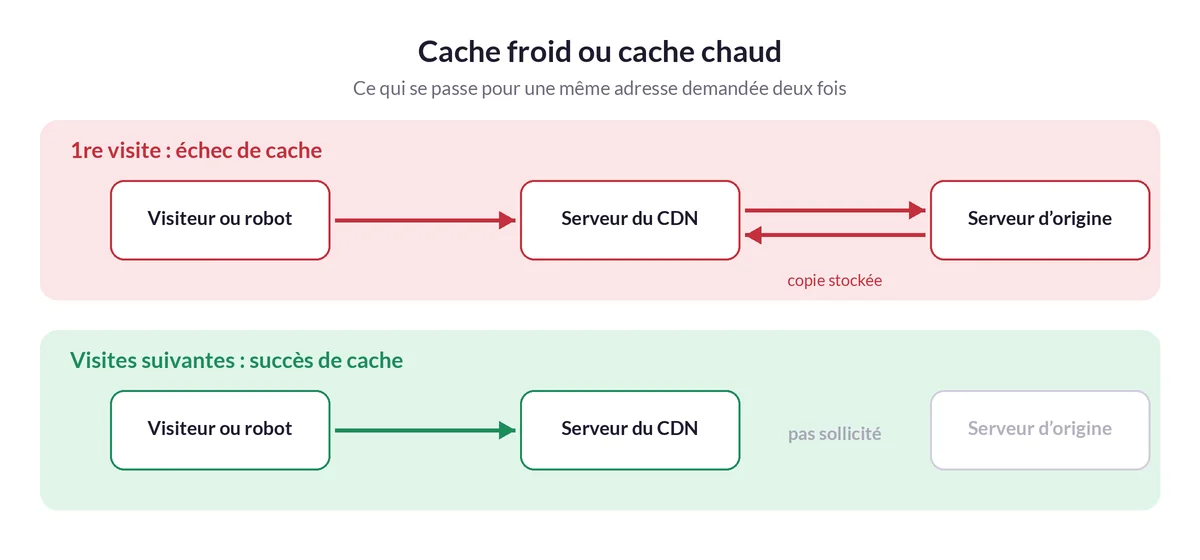
À la première demande d’une adresse, le serveur périphérique n’en a pas encore de copie : c’est un « échec de cache ». Il doit alors remonter jusqu’à votre serveur d’origine, récupérer la page, la stocker, puis la servir. Seules les demandes suivantes pour cette même adresse sont servies directement par le CDN.
Et c’est là que les comportements divergent. Les visiteurs humains se concentrent sur quelques pages populaires (l’accueil, les articles phares, les promotions), qui entrent vite en cache. Les robots, eux, font l’inverse : leur rôle est de parcourir toutes vos adresses. Chaque page rarement visitée déclenche donc un échec de cache qui retombe sur votre serveur. Conclusion de Google : au lancement d’un CDN, le véritable goulot d’étranglement reste le serveur d’origine.
Google tempère un peu : ses robots n’augmentent pas leur vitesse d’un coup, et de nombreux CDN lissent déjà les pics de connexions. Mais tant que les caches ne sont pas remplis, le CDN ne sert pas encore de bouclier.
Deuxième piège : bloquer Googlebot par excès de prudence
Face à cette hausse soudaine de requêtes automatisées, la tentation est grande d’activer la protection globale contre les robots dans le tableau de bord du CDN. Mauvaise idée, prévient Google : ces règles traitent tous les robots de la même façon, y compris les siens.
Si votre CDN ou votre pare-feu applicatif présente un test de type CAPTCHA aux visites automatisées, les robots de Google échouent. Ils tombent sur une page d’erreur et, de leur point de vue, votre site semble « délibérément restreint ou défectueux ». Sans intervention de votre part, ils finissent par se retirer, et vos pages, fiches produits et photos commencent à disparaître de la recherche.
Ce risque ne concerne pas que Google : les mêmes réglages peuvent bloquer les robots des moteurs de réponse par IA, comme nous l’expliquions dans notre article pour apparaître dans les réponses de ChatGPT et de Google.
Le plan en trois étapes recommandé par Google
Bonne nouvelle : pas besoin d’appeler les pompiers, plaisante Google. Il suffit d’avoir les bonnes attentes et un plan d’action.
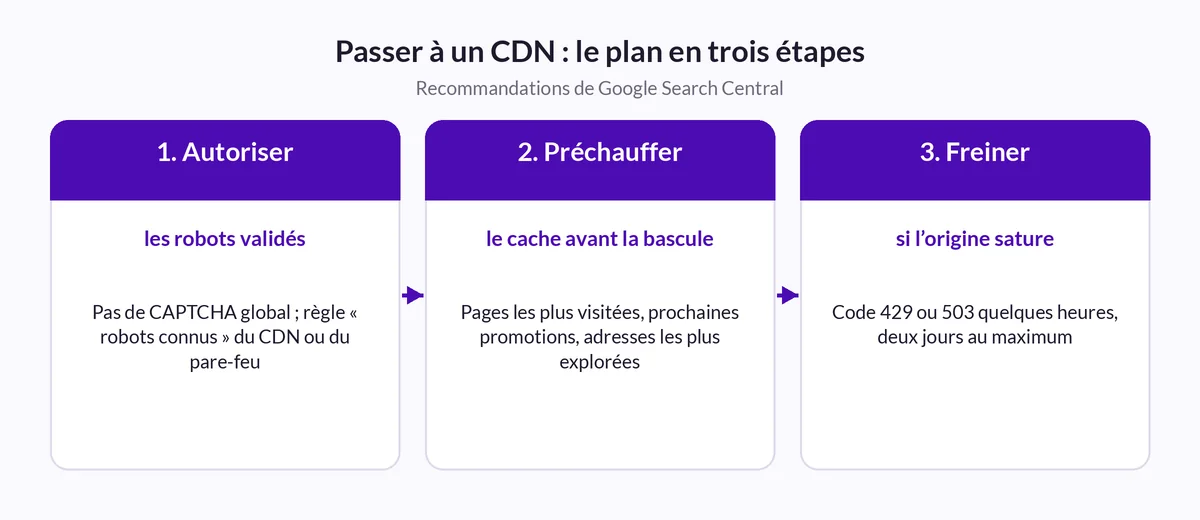
1. Autoriser les robots validés
Si vous devez filtrer les robots, autorisez les robots « connus » ou « validés » dans les réglages de votre CDN et de votre pare-feu : la plupart des grands CDN proposent un bouton ou une règle prête à l’emploi pour cela. Mieux encore, selon Google : ciblez les robots indésirables précis, via votre fichier robots.txt ou des règles dédiées, plutôt que de bloquer tous les visiteurs automatisés.
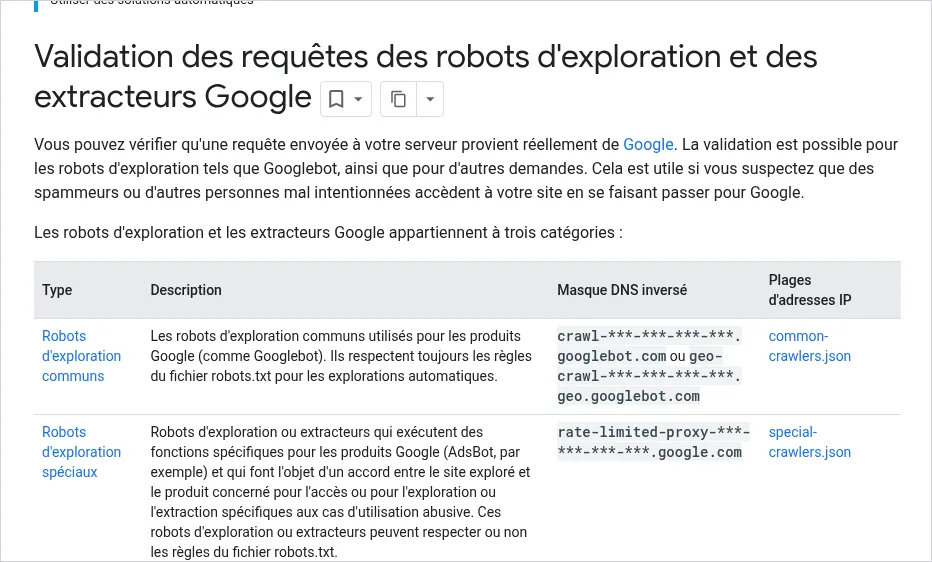
Pour reconnaître un vrai robot de Google, sa page sur la vérification des robots d’exploration décrit deux méthodes : comparer l’adresse IP à la liste des plages publiées par Google, ou faire une résolution DNS inverse puis directe. Le nom obtenu doit appartenir à googlebot.com, google.com ou googleusercontent.com, et renvoyer la même adresse IP.
2. Remplir les caches avant d’ouvrir les vannes
Avant de faire basculer tout le trafic vers le CDN, Google conseille de visiter de manière automatisée, et à un rythme maîtrisé, vos pages les plus fréquentées, celles qui vont bientôt l’être (une promotion saisonnière, un lancement) et les adresses les plus explorées par les robots. Les caches seront ainsi prêts à encaisser le trafic. Google suggère même, avec humour, de demander à des amis d’ouvrir chacun deux adresses différentes : « Cela fonctionne aussi. »
Pour savoir quelles adresses Google explore le plus, consultez les journaux d’accès de votre serveur ou demandez-les à votre hébergeur. Si vous hésitez encore sur l’hébergement lui-même, notre comparatif OVH ou o2switch vous aide à choisir.
3. Freiner temporairement avec un code 429 ou 503
Si l’exploration surcharge encore votre serveur pendant que les caches se remplissent, réglez la limitation de débit de votre serveur ou de votre CDN pour renvoyer un code 429 (trop de requêtes) ou 503 (service indisponible), pendant une courte période : de quelques heures à un ou deux jours au maximum.
La page de Google pour réduire la vitesse d’exploration en urgence précise le mécanisme. Face à un nombre important d’adresses en erreur 500, 503 ou 429, Google réduit l’exploration sur tout le nom d’hôte, puis la remonte automatiquement quand les erreurs diminuent. Vous pouvez ajouter un en-tête Retry-After pour indiquer quand revenir.
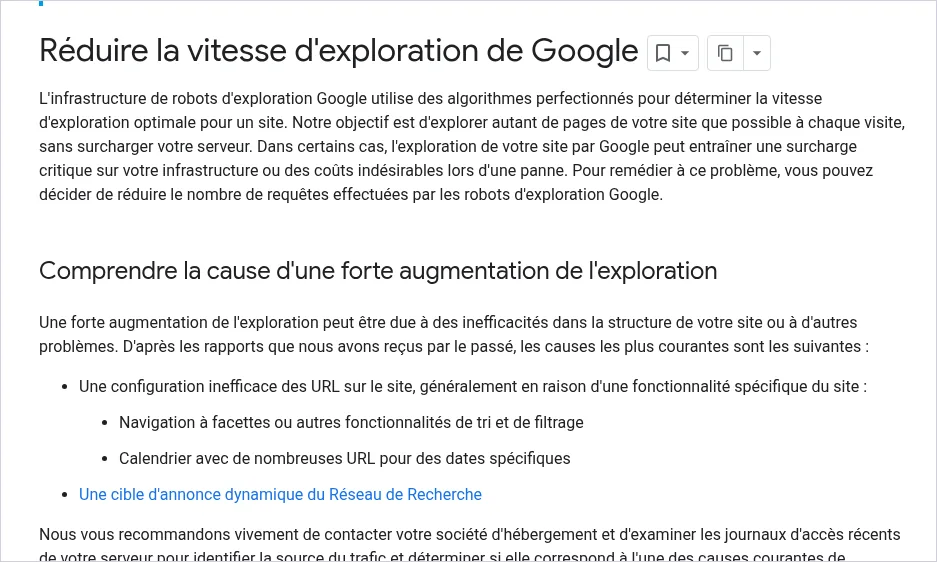
Si vous ne pouvez pas renvoyer ces erreurs, un formulaire de demande spéciale existe pour signaler une exploration anormalement élevée. Mais il ne permet pas de demander une hausse, et son traitement peut prendre plusieurs jours. Le code temporaire reste donc l’outil le plus réactif, à condition de le garder vraiment temporaire. Google prévient en effet que ce frein a des effets globaux : moins de nouvelles pages découvertes, des prix et disponibilités de produits actualisés plus lentement, et même des campagnes Google Ads qui peuvent être suspendues. Au-delà d’un à deux jours, si Googlebot voit ces codes plusieurs jours de suite sur la même adresse, celle-ci peut être retirée de l’index.
Avant la bascule : la liste de contrôle
- Prévenez votre hébergeur et regardez la capacité de votre serveur d’origine.
- Repérez vos pages clés : les plus visitées, les plus explorées et les prochaines pages promotionnelles.
- Préchauffez le cache sur ces pages avant de changer le DNS.
- Vérifiez les règles anti-robots : robots validés autorisés, pas de CAPTCHA global.
- Préparez le frein d’urgence : une règle 429 ou 503 prête à activer quelques heures.
- Surveillez la Search Console après la bascule, notamment le rapport sur les statistiques d’exploration et les erreurs de serveur.
Un site rapide reste un atout, pour vos visiteurs comme pour votre référencement. Pour aller au bout de la démarche, allégez aussi vos médias avec notre guide sur le SEO des images, et si votre site tourne sous WordPress, la formation Maîtriser WordPress vous apprend à le garder léger et bien réglé.
Questions fréquentes
Un CDN améliore-t-il directement mon référencement ?
Google présente le CDN comme un moyen de réduire la latence pour les visiteurs et de protéger votre serveur d’origine. Il note aussi que des réponses rapides et stables poussent ses robots à explorer davantage. Le bénéfice passe donc par la vitesse et la stabilité du site.
Pourquoi mon serveur est-il plus sollicité juste après le passage au CDN ?
Parce que le cache du CDN est vide au départ. Chaque première demande d’une adresse remonte jusqu’à votre serveur, et les robots de Google, encouragés par des réponses plus rapides, parcourent toutes vos pages, y compris celles que les visiteurs consultent rarement.
Puis-je activer la protection anti-robots de mon CDN ?
Oui, à condition d’exempter les robots validés. Une protection globale avec CAPTCHA bloque aussi Googlebot, et Google prévient que vos pages peuvent alors commencer à disparaître de la recherche.
Comment savoir si une visite vient vraiment de Googlebot ?
Google propose deux méthodes : comparer l’adresse IP aux plages qu’il publie, ou effectuer une résolution DNS inverse puis directe. Le nom doit appartenir à googlebot.com, google.com ou googleusercontent.com et pointer vers la même adresse IP.
Combien de temps puis-je renvoyer un code 503 aux robots ?
Google recommande de limiter ce frein à une courte période, de quelques heures à un ou deux jours au maximum. L’exploration reprend automatiquement quand les erreurs diminuent, mais si une même adresse renvoie ces codes pendant plusieurs jours, elle peut être retirée de l’index.